Integration von Large Language Models (LLMs) 2026: OpenAI- und Claude-API für Entwickler
Wie man die APIs von OpenAI und Anthropic anspricht, welche Modelle im September 2026 aktuell sind, und ein Rechenbeispiel zu Prompt Caching, Antwortlänge und Modellwahl.
Am 23. Oktober 2026 schaltet OpenAI 17 Modelle und Modellvarianten ab, darunter o1, o1-pro, o4-mini, gpt-4-turbo und das Bildmodell gpt-image-1 (Übersicht der Abkündigungen). Eine Anwendung, die einen dieser Namen fest im Quelltext führt, bekommt ab diesem Tag Fehler statt Antworten. Der Aufruf selbst ist dagegen schnell geschrieben, zehn Zeilen Python genügen. Aufwand macht eine LLM-Integration an zwei anderen Stellen: bei Modellen, die nach Plan verschwinden, und bei einer Rechnung, die mit jedem Token wächst.
Diese Anleitung zeigt den ersten Aufruf bei OpenAI und bei Anthropic und rechnet danach an einem Beispiel durch, welcher Kostenhebel wie viel bringt. Modellnamen und Preise stammen aus den Dokumentationen der Anbieter, abgerufen am 28. September 2026.
Welche Modelle im September 2026 aktuell sind
OpenAI führt seine aktuellen Modelle im Modellkatalog, Anthropic in der Modellübersicht. Zusammen stehen dort sieben Modelle:
| Anbieter | Modell | API-ID | Kontext | Input / Output je 1 Mio. Token |
|---|---|---|---|---|
| OpenAI | GPT-6 Astra | gpt-6-astra |
1,05 Mio. | 10 $ / 50 $ |
| OpenAI | GPT-6 Sol | gpt-6-sol |
1,05 Mio. | 2 $ / 10 $ |
| OpenAI | GPT-6 Luna | gpt-6-luna |
1,05 Mio. | 0,10 $ / 0,50 $ |
| Anthropic | Claude Fable 5.1 | claude-fable-5-1 |
1 Mio. | 10 $ / 50 $ |
| Anthropic | Claude Opus 5.5 | claude-opus-5-5 |
1 Mio. | 4 $ / 20 $ |
| Anthropic | Claude Sonnet 5 | claude-sonnet-5 |
1 Mio. | 2 $ / 10 $ |
| Anthropic | Claude Haiku 4.5 | claude-haiku-4-5-20251001 |
200.000 | 1 $ / 5 $ |
Bei allen sieben kostet ein Output-Token genau das Fünffache eines Input-Tokens. Das bestimmt weiter unten, wo sich Sparen lohnt. GPT-6 Astra hat zusätzlich einen Aufschlag für sehr lange Eingaben: Ab 272.000 Input-Token wird die ganze Anfrage zum doppelten Input- und zum 1,5-fachen Output-Preis abgerechnet (Modellseite zu GPT-6 Astra).
Wie kurz ein Modell an der Spitze steht, zeigt Claude Opus 5. Anthropic hat es am 24. Juli 2026 veröffentlicht, zwei Monate später fehlt es in der Übersicht, und die Modellseite legt den Umstieg auf Opus 5.5 nahe. Bei OpenAI ist die GPT-5.6-Reihe mit gpt-5.6-sol, gpt-5.6-terra und gpt-5.6-luna aus dem Katalog in die vollständige Modellliste gewandert. Nutzbar bleibt sie, und für die meisten der abgekündigten Modelle nennt OpenAI sie als Ersatz.
Wann ein Name verschwindet, steht mit Vorlauf in den Abkündigungslisten. gpt-4.5-preview, den frühere Fassungen dieser Anleitung empfahlen, hat OpenAI am 14. Juli 2025 entfernt. Nach dem 23. Oktober folgen am 11. Dezember 2026 die datierten Fassungen von gpt-5, gpt-5-mini, gpt-5-nano und o3. Anthropic hat claude-3-5-sonnet-20240620 am 28. Oktober 2025 abgeschaltet, Claude 3.5 Haiku am 19. Februar 2026 sowie Claude Opus 4 und Sonnet 4 am 15. Juni 2026 (Liste der Abkündigungen).
Der Modellname gehört deshalb in die Konfiguration, zum Beispiel in eine Umgebungsvariable, und nicht in den Quelltext. Die Beispiele unten tragen ihn nur der Kürze halber direkt im Aufruf.
Erster Aufruf über die OpenAI API
Für Textanfragen bietet OpenAI zwei Schnittstellen. Die ältere Chat Completions API wird weiter unterstützt, für neue Projekte empfiehlt OpenAI die Responses API (Migrationsleitfaden). Das Beispiel nutzt Chat Completions, weil es die kürzeste Form ist und sich neben den Aufruf bei Anthropic legen lässt. Wer neu anfängt, beginnt besser gleich mit Responses.
Das Modell im Beispiel, gpt-5.6-sol, ist nicht mehr das neueste, aber verfügbar. In der GPT-6-Reihe regelt der Parameter reasoning.effort, wie viel Rechenaufwand in eine Antwort geht: bei Sol und Luna von none bis max, bei Astra ab low.
Voraussetzungen
ein API-Konto bei OpenAI und ein API-Schlüssel, im Beispiel aus der Umgebungsvariable
OPENAI_API_KEYgelesendas Python-Paket
openaiGrundkenntnisse in Python, HTTP und JSON
# OpenAI API Basisintegration
import os
from openai import OpenAI

# Client initialisieren
client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY")
)

# Anfrage an das Modell senden
response = client.chat.completions.create(
    model="gpt-5.6-sol",
    messages=[
        {"role": "system", "content": "Du bist ein hilfreicher Assistent."},
        {"role": "user", "content": "Erkläre mir die Vorteile von APIs in einfachen Worten."}
    ]
)

# Antwort ausgeben
print(response.choices[0].message.content)
Was die Responses API seit Mai 2025 zusätzlich kann
Am 21. Mai 2025 hat OpenAI die Responses API um eingebaute Werkzeuge erweitert, die Chat Completions nicht hat (Ankündigung). Sie ruft Werkzeuge auf entfernten Model-Context-Protocol-Servern auf, womit agentenartige Anwendungen keine eigene Adapterschicht mehr brauchen. Code Interpreter und Bildgenerierung laufen als Werkzeuge direkt in der API. Der Background Mode arbeitet lange Läufe asynchron ab, statt sie in ein Request-Timeout laufen zu lassen. Mit derselben Ausgabe kamen Zusammenfassungen der Reasoning-Schritte und, für Kunden mit Zero Data Retention, verschlüsselte Reasoning-Items. Diese lassen sich über mehrere Anfragen wiederverwenden, ohne dass OpenAI sie speichert.
Auch hier altern die Namen: Das damals vorgestellte Bildmodell gpt-image-1 steht auf der Abschaltliste für den 23. Oktober 2026, Nachfolger ist gpt-image-2.
Erster Aufruf über die Claude API
Anthropics Schnittstelle ähnelt der von OpenAI. Wer Code von einem Anbieter auf den anderen überträgt, muss an drei Stellen umbauen (API-Referenz). Anfragen gehen an POST /v1/messages. Die Systemanweisung steht in einem eigenen Feld system auf oberster Ebene, eine Rolle „system“ in der Nachrichtenliste gibt es nicht. Und max_tokens ist Pflicht, jede Anfrage nennt also eine Obergrenze für die Antwortlänge.
Wer beide Anbieter ansprechen will, zieht deshalb eine dünne eigene Zwischenschicht ein, bevor sich die Aufrufe über den Code verteilen. Nachträglich ist das mühsam.
Das Beispiel verwendet Claude Sonnet 5, laut Anthropics Preisliste die beste Verbindung aus Geschwindigkeit und Leistung. Der Schlüssel kommt aus ANTHROPIC_API_KEY, das Python-Paket heißt anthropic.
# Claude API Basisintegration
import os
import anthropic

# Client initialisieren
client = anthropic.Anthropic(
    api_key=os.environ.get("ANTHROPIC_API_KEY")
)

# Anfrage an Claude senden
message = client.messages.create(
    model="claude-sonnet-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "Erkläre mir die Vorteile von AI-Integrationen für Entwickler."}
    ]
)

# Antwort ausgeben
print(message.content[0].text)
Was ein Aufruf kostet: ein Rechenbeispiel
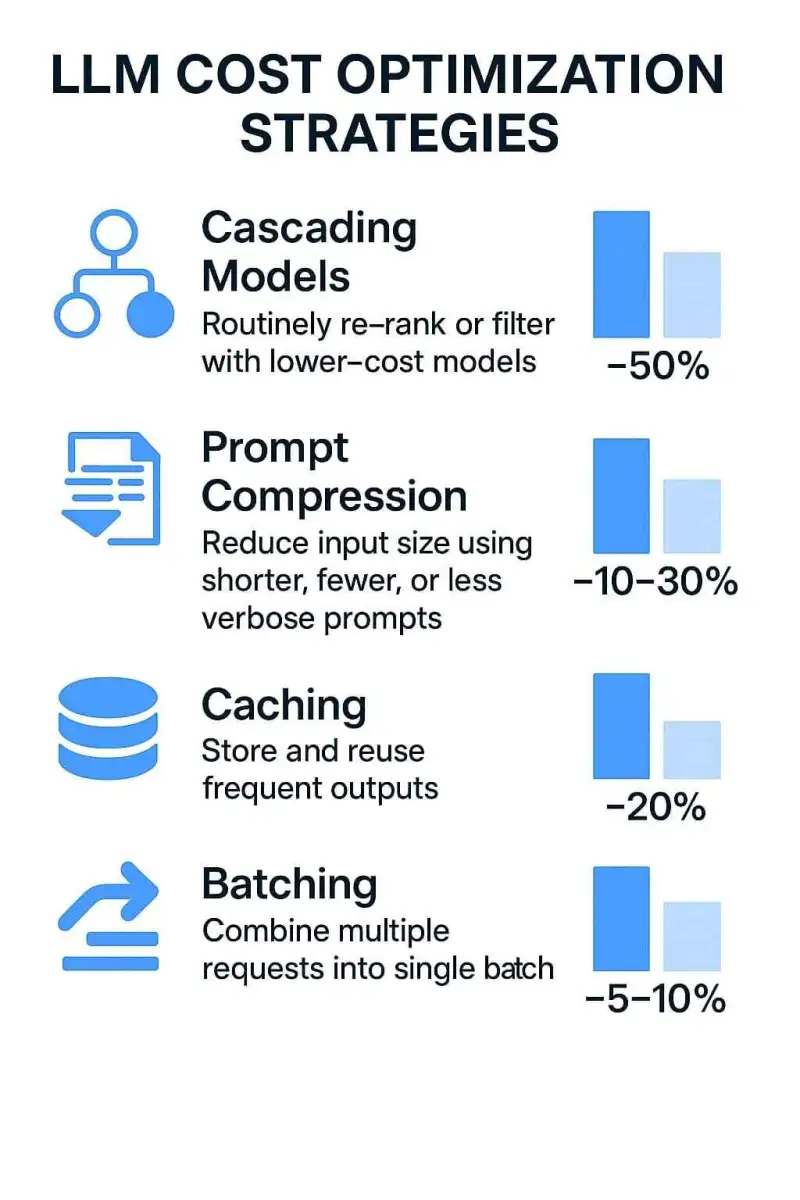
Beide Anbieter rechnen nach Token ab, Eingabe und Ausgabe getrennt. Wie sich die Hebel zueinander verhalten, zeigt ein durchgerechnetes Beispiel. Angenommen ist ein Support-Assistent auf Claude Sonnet 5 mit 1.000 Anfragen am Tag. Jede Anfrage besteht aus einem festen System-Prompt mit 2.800 Token und einer Nutzerfrage mit 200 Token, die Antwort hat 500 Token. Die Preise stammen aus der Preisliste von Anthropic.
Ohne weitere Maßnahmen: 3 Millionen Input-Token zu 2 $ je Million kosten 6,00 $, 500.000 Output-Token zu 10 $ je Million 5,00 $. Zusammen 11,00 $ am Tag.
Mit Prompt Caching: Die 2,8 Millionen Token des festen Prompts kommen aus dem Cache, zu 0,20 $ je Million, also 0,56 $. Die Nutzerfragen kosten weiter den vollen Preis, 0,40 $. Mit unveränderter Ausgabe ergibt das 5,96 $.
Zusätzlich mit halbierter Antwortlänge: 250 statt 500 Token je Antwort senken die Ausgabe auf 2,50 $. Summe 3,46 $, knapp ein Drittel des Ausgangswerts.
Zum Vergleich Claude Haiku 4.5 ohne Cache: 3,00 $ Input und 2,50 $ Output, zusammen 5,50 $.
Nach Schritt 2 entfallen 5,00 von 5,96 $ auf die Ausgabe, 84 Prozent. Weil ein Output-Token bei jedem Modell der Tabelle fünfmal so viel kostet wie ein Input-Token, bleibt die Antwortlänge danach der größte Posten. Der Wechsel auf Haiku in Schritt 4 spart etwa so viel wie der Cache, sofern das kleinere Modell die Aufgabe ebenso gut löst. Mit dem Cache kombinieren lässt er sich in diesem Beispiel aber nicht: Haiku 4.5 cacht erst Prompts ab 4.096 Token, und ein kürzerer fester Teil läuft ohne Cache und ohne Fehlermeldung durch.
Prompt Caching: was genau berechnet wird
Das Beispiel setzt voraus, dass der Cache warm bleibt. Bei Anthropic lebt ein Eintrag standardmäßig fünf Minuten und wird bei jedem Treffer ohne Aufpreis verlängert (Dokumentation zum Prompt Caching). 1.000 Anfragen am Tag heißen im Mittel eine alle 86 Sekunden. Vergehen zwischen zwei Anfragen aber mehr als fünf Minuten, muss der Eintrag neu angelegt werden. Das kostet das 1,25-Fache des Input-Preises, im Beispiel 0,7 Cent statt 0,056 Cent für einen Lesezugriff. Die Variante mit einer Stunde Lebensdauer kostet beim Anlegen das Doppelte. Gelesen wird bei den meisten Claude-Modellen zu einem Zehntel des Input-Preises, bei Opus 5.5 zu einem Zwanzigstel und bei Fable 5.1 zu einem Vierzigstel.
OpenAI rechnet seit GPT-5.6 nach demselben Muster: Anlegen zum 1,25-Fachen, Lesen zum 0,1-Fachen des Input-Preises, Mindestlänge 1.024 Token, Lebensdauer standardmäßig 30 Minuten (Leitfaden zum Prompt Caching). Ältere Modelle kennen keine Gebühr fürs Anlegen, ihr Rabatt beim Lesen hängt vom Modell ab und reicht bis 90 Prozent. GPT-6 Sol hat dieselben Listenpreise wie Claude Sonnet 5. Das Rechenbeispiel kommt dort also auf dieselben Beträge, nur muss der Cache wegen der längeren Lebensdauer seltener neu angelegt werden.
Der Cache greift nur auf einen unveränderten Anfang des Prompts. Anweisungen und Beispiele, die sich nie ändern, gehören deshalb nach vorn, alles Veränderliche ans Ende.
Antwortlänge und Kontext begrenzen
Die Antwortlänge lässt sich auf zwei Wegen begrenzen: über eine Anweisung im Prompt und über die harte Obergrenze max_tokens. Die Obergrenze allein beendet die Ausgabe, sobald sie erreicht ist, notfalls mitten im Satz. Die gewünschte Länge gehört deshalb zusätzlich in den Prompt.
Auf der Eingabeseite lohnt sich zweierlei. Anweisungen, die in Systemnachricht und Nutzernachricht doppelt stehen, werden doppelt bezahlt. Und vom verfügbaren Kontext geht nur mit, was diese eine Anfrage braucht.
LLM Cascading
Beim Cascading durchläuft eine Anfrage eine Kette von Modellen, beginnend beim günstigsten. Erst wenn dessen Antwort eine Prüfstufe nicht besteht, geht sie an ein teureres Modell weiter. Beschrieben haben das Verfahren Lingjiao Chen, Matei Zaharia und James Zou in FrugalGPT, eingereicht am 9. Mai 2023. Laut Zusammenfassung erreicht es die Leistung des damals besten Einzelmodells GPT-4 bei bis zu 98 Prozent geringeren Kosten, oder bei gleichen Kosten eine um 4 Prozent höhere Genauigkeit.
Die 98 Prozent sprechen für das Verfahren, sind aber kein Erwartungswert. Gemessen wurde mit den Modellen und Preisen von 2023. Was in der eigenen Anwendung übrig bleibt, hängt an der Prüfstufe: Lässt sie schwache Antworten durch, spart die Kette auf Kosten der Qualität. Weist sie zu viele zurück, zahlt ein großer Teil der Anfragen doppelt.
RAG und semantisches Caching
Retrieval-Augmented Generation (RAG) reicht dem Modell nur die passenden Ausschnitte aus einer Datenquelle, statt bei jeder Anfrage einen großen Kontext mitzuschicken. Wie viel das spart, hängt vom Verhältnis zwischen Gesamtbestand und benötigtem Ausschnitt ab, eine allgemeingültige Zahl gibt es nicht. Da die Ausschnitte von Anfrage zu Anfrage wechseln, gehören sie hinter den festen, gecachten Teil des Prompts.
Semantisches Caching setzt eine Ebene höher an. Es beantwortet wiederkehrende Fragen aus einem eigenen Speicher, ganz ohne Modellaufruf, während das Prompt Caching der Anbieter den Aufruf nur verbilligt.
Prompt Engineering für Entwickler
Prompt Engineering heißt, die Eingabe so zu formulieren, dass das Modell die Aufgabe beim ersten Mal trifft. Mit den Kosten hängt das unmittelbar zusammen: Jede Antwort, die nachgebessert werden muss, kostet einen zweiten Aufruf.
Zero-Shot vs. Few-Shot Prompting
Zero-Shot Prompting gibt dem Modell nur die Anweisung, ohne Beispiel. Für klar umrissene Aufgaben genügt das.
Few-Shot Prompting stellt zwei bis fünf Beispielpaare voran, die Eingabe und gewünschte Ausgabe zeigen. Am deutlichsten wirkt das bei Formatvorgaben: Soll die Antwort ein JSON-Objekt mit festen Schlüsseln sein, überzeugt ein einziges Beispiel das Modell zuverlässiger als drei Sätze Beschreibung. Die Beispiele laufen bei jedem Aufruf mit und kosten Token. Stehen sie im festen Teil des Prompts, kommen sie wie der System-Prompt im Rechenbeispiel aus dem Cache.
Fünf Regeln für Prompts
Kontext vor Anweisung. Das Modell kennt weder Ihr Datenmodell noch Ihre Namenskonventionen. Was es wissen muss, gehört in den Prompt.
Format zeigen, nicht beschreiben. Ein Beispiel der gewünschten Ausgabe schlägt jede Erklärung.
Große Aufgaben teilen. Zwei Aufrufe mit klarem Zuschnitt liefern verlässlicher als einer, der alles auf einmal erledigen soll. Dieselbe Regel gilt für Programmierassistenten, siehe den Leitfaden zu GitHub Copilot und Cursor.
Festes nach vorn. Anweisungen und Beispiele, die sich nie ändern, stehen am Anfang des Prompts. Nur so greift der Cache.
Verfeinern heißt messen. Ohne einen kleinen Satz Testfälle bleibt jede Prompt-Änderung eine Vermutung.
Zusammenfassung
Über eine LLM-Integration entscheiden vier Punkte mehr als die Wahl des Anbieters.
Modellnamen gehören in die Konfiguration. Beide Anbieter schalten Modelle nach Plan ab, mit Vorlauf, aber ohne Ausnahme. Bei OpenAI trifft es am 23. Oktober 2026 17 Modelle und Varianten an einem Tag.
Erst cachen, dann kürzen. Im Rechenbeispiel halbiert der Cache die Rechnung beinahe, danach liegt der größte Posten bei der Ausgabe.
Cascading braucht eine Prüfstufe, der man traut. Ohne sie verschiebt die Kette den Fehler nur nach hinten und bezahlt ihn zweimal.
Prompts brauchen Testfälle. Sonst lässt sich nach einer Änderung nicht sagen, ob sie geholfen hat oder nur anders war.